145
Использование классов слов
для определения авторства
Настоящее исследование построено по методу, уже примененному и описанному для двух предшествующих случаев. Во-первых, оно присутствовало в условном эксперименте с целью определения авторства текстов советских писателей К. Симонова и К. Паустовского1; во-вторых, в связи с целевым исследованием настоящего случая, с Крюковым и Шолоховым, как возможными авторами «Тихого Дона»2.
Симонов и Паустовский
Критерием, примененным в этом случае, была дистрибуция классов слов в позиции начала и конца фразы. Выбор такого критерия был обусловлен следующими причинами:
— автор в процессе письма не осуществляет осознанного контроля над подбором классов слов;
— классы слов могут быть рассмотрены объективно сторонним наблюдателем;
— классы слов не отражают содержания написанного;
— автор бессознательно конструирует свои фразы более или менее уникальным образом;
146
— то, как автор конструирует фразы, отражается, наряду с прочим, в дистрибуции классов слов в начале и конце фразы.
Автономные статистические данные были получены по первым двум и последним трем позициям фраз. Пять статистических профилей, полученных таким образом, были приняты за характерные для авторов тех фраз, о которых идет речь. То, что мы можем назвать справочным фондом, составлялось из 2000 фраз каждого автора. Тестируемый фонд включил еще 2000 фраз, поделенных на секции по 100 фраз каждая. Тест X2 каждого испытуемого текста проводился применительно к каждому справочному корпусу, чтобы установить, к какому из них испытуемый текст наиболее близок. Хотя величина X2 получалась иногда слишком высокой, но в 19 случаях из 20 и в 18 случаях из 20 соответственно, она была существенно ниже для «верного» автора, чем для «неверного». Разница между «верным» и «неверным» автором была тем больше, чем больше сочетались проверяемые тексты.
Кроме того, было проведено исследование распространеннейших комбинаций классов слов для начала и конца фраз, по 2000 фраз на каждого автора. Никакие данные этого текста не использовались, но, помимо прочего, можно было сделать следующие наблюдения: частотность определенных комбинаций (выраженная в %) у обоих авторов значительно варьировалась. Например, в начале фразы существительное в роли подлежащего, за которым следует глагол, встречалось в 11,5% случаев у Симонова, тогда как соответствующей величиной для Паустовского было 19,3%, и аналогично местоимение в сопровождении глагола встречалось 9,9% в случае у Симонова и 15,3% — во фразах Паустовского; в позиции начала фразы, пять самых обычных комбинаций соответствовали
147
38,6% всех симоновских вступлений, тогда как у Паустовского — 52,2%, а в позиции конца фразы десять наиболее частых случаев соответствовали 37,8% у Симонова и 48,1 — у Паустовского.
Целевое исследование
Первое пробное исследование Гейра Хьетсо «Буря над «Тихим Доном» рассматривало тексты Шолохова, Крюкова и «Тихого Дона» с описанной выше точки зрения. Результаты, выявленные в пользу Шолохова, были представлены и анализировались в печати, поэтому не будут здесь рассматриваться. Однако исследование подтвердило, что метод, основанный на анализе классов слов, может быть применен и здесь. Поэтому я использовал его в более масштабном исследовании, которое проводил при помощи компьютера. Результаты исследования ныне доступны. В качестве критерия были взяты комбинации классов слов сами по себе и в целых фразах.
Задание по классам слов
Задание по классам слов, как и в исследовании Симонова — Паустовского, так и в целевом исследовании, проводилось вручную. Вне зависимости от трудоемкости этот метод несовершенен в том смысле, что объективного и убедительного результата нельзя гарантировать. Когда Свен Густавссон в 1975 году начал работу над проектом под названием «Кто написал «Тихий Дон»?» в Вычислительном центре Упсалы под руководством Анны-Лены Согвалл1, уже существовала автоматизированная аналитическая система.
148
Эта система распределяет слова по морфологическим классам, согласно флексионным окончаниям и другим формальным характеристикам. Возникающая в результате модифицированная классификация слов обладает убедительностью, а это куда важнее, нежели «правильность», с человеческой точки зрения. Семь основных классов, полученных в анализируемой системе, описаны в книге Анны-Лены Согвалл следующим образом.
Класс 1 (класс «существительных») включает лексемы с флексионным отражением падежа и числа.
Прилагательные, определительные местоимения и числительные, которые все выражают род, так же как и падеж, и число, посредством флексий, распределяются между двумя классами: классом 2 и классом 3. Класс 2 содержит определительные слова, формальная структура которых препятствует проявлению оппозиции краткости-полноты формы в флексионных парадигмах, благодаря «смеси» номинальных и прономинальных форм. Следовательно, класс 2 содержит такие слова, как божий, кошкин, весь, мой, ваш, один, сам, сей, этот и т. д.
Поскольку личные местоимения в третьем лице, согласно нашему определению лексемы, считаются реализациями одной лексемы, он, и род, падеж и число, таким образом, рассматриваются как флексионные категории, то лексема он также входит в класс 2.
Другие определительные типы (прилагательные, местоимения и числительные) относятся к классу 3. Отношение краткости-полноты формы рассматривается в этом классе как флексионная категория, а также степень сравнения, кроме рода, числа и падежа. Появление этих форм всегда предсказуемо для представителей этого класса при условии, что они допустимы по семантике лексемы. (Нам представилась нецелесообразной на этом этапе попытка
149
разграничения лексем, реализующих оппозицию полноты-краткости формы, так же как и степени сравнения.) Это — проблема семантики, которая не может быть успешно разрешена в пределах данной аналитической системы. Грубое распределение на классы предпочтительнее субъективно дифференцированной классификации. Усовершенствование ее потребовало бы системного, предпочтительно компьютерного, исследования (ср. то, что говорилось о концепции лексемы). Класс 3, следовательно, включает слова вроде бедный, березовый, домашний, какой, второй, столовый, недокуренный и др.
Класс 4 включает слова с флексионным выражением одного только падежа, тогда как класс 5 объединяет слова и с регулярным отражением рода. Класс 4 составлен по преимуществу из количественных числительных (начиная с три). Он также включает кто и что с их производными, себя и собирательные числительные. Мы принимаем я, ты, мы, вы соответственно за отдельные лексемы. Следовательно, никакой оппозиции, связанной с категорией числа, не имеется, и эти четыре лексемы относятся к классу 4. Во всех есть три представителя класса 5, именно — два, оба, полтора.
Представители класса 6, несклоняемые, характеризуются отсутствием флексионных категорий. Класс этот включает предлоги, союзы, наречия, вводные слова, частицы и т. д.
К классу 7 (глагольному классу) относятся лексемы с регулярным отражением времени, лица, числа, залога, рода и падежа. В этом классе, как и в 3-м, каждая форма лексемы не выражает всех этих категорий (ср. крайнюю форму прилагательного, которая только выражает род (в ед. числе) и число, тогда как полная форма выражает и падеж). Следовательно, глагольные формы подразделяются на
150
определенные формы (время, число, лицо, род); императивы (лицо, число); инфинитивы (—), герундии (время), причастия (время, залог, краткость-полнота формы, род (падеж), число).
Таким образом, классификация на основные или главные аналитические классы применяется на уровне лексемы. В случае с классами 3 и 7 слово в пределах лексического оформления подразделяется на вторичные аналитические классы, основанные на концепции грамматической категории. Классификация на первичные, так же как и вторичные, анализируемые классы отражена в аналитической шкале. Как будет показано, имеется резкое различие между аналитической стратегией класса 7 и тем же в других классах. Это связано с сегментацией, необходимой для анализа, и в самом деле мотивирует начальную, более широкую классификацию на глаголы и прочие слова. Такая классификация, однако, релевантна лишь для анализа алгоритма, а не для нового кода, как это представляется нам1.
Для настоящего исследования эта система была модифицирована и расширена применительно к исследованию. Так, рамки классификации были расширены до включения подклассов — всего до 25. Система помещает каждое слово внутри класса и каждую фразу делает последовательностью букв, означающих классы, от А до Y:
А — Номинативы одушевленные | | Основной класс 1 |
В — Другие случаи одушевленных | ||
С — Номинативы неодушевленные | ||
D — Другие случаи неодушевленных |

151
Е — Номинативы | | Основной класс 2 | |
F — Прочие формы | |||
G — Полные формы, номинативы | | Основной класс 3 | |
Н — Полные формы, прочие случаи | |||
I — Краткие формы, сравнительные формы, например, яснее | |||
J — Номинативы от кто, что, мы, вы, я, ты | | Основной класс 4 | |
К — Прочие формы местоимений, упоминаемых в J | |||
L — Прочие представители основного класса 4 | |||
М — Все формы | Основной класс 5 | ||
N — Собственно предлоги, вроде без, безо, в, во | | Основной класс 6 | |
О — Предлоги, которые могут быть также наречиями, например, вблизи, внутри, вдоль | |||
Р — Собственно союзы, как а, и, или | |||
Q — Союзы, которые могут быть также наречиями, например, да, однако, пока | |||
R — Прочие представители класса 6 | |||
S — Инфинитивы | | Основной класс 7 | |
Т — Деепричастия | |||
U — Причастия, полные формы, номинативы | |||
V — Причастия, полные формы, прочие случаи | |||
W — Причастия, краткие формы | |||
152
X — Прочие формы, принадлежащие основному классу 7 | | Основной класс 7 |
Y — Все пунктуационные знаки, кроме разделительных для предложений |
Эта детальная классификация была предложена во избежание пропуска классов, которые могли бы служить разграничению между авторами. При этом, однако, мы подвергаемся риску, что классы наши более зависят от содержания, чем от стиля. Это верно, например, в отношении классов существительных одушевленных и неодушевленных, которые, быть может, следовало бы объединить. Заметим также, что перечень не включает возможные омографы форм, принадлежащих другим основным классам.
Объем корпуса
Перечень анализируемых текстов был приведен в предисловии. В нашем случае корпус включает в целом свыше 3 700 фраз из произведений Крюкова, общим количеством примерно в 50 000 слов, и около 5 000 фраз из произведений Шолохова, всего примерно на 67 000 слов. Корпус ТД (3 760 фраз или 48 094 слов) был разделен на фрагменты из 200 фраз и, для основной части исследования, на меньшие единицы.
Дабы увериться, что сравниваются тексты внешне однородные, мы решили исключить прямую речь и вопросительные предложения. Другими словами, наше исследование сосредоточено на собственном языке автора.
Основное допущение в исследовании такого рода состоит в том, что стилистические различия в произведениях
153
одного автора меньше стилистических различий в произведениях разных авторов. Хотя это было бы желательно, но варианты произведений, бесспорно принадлежащих анализируемым авторам, не рассматривались. Точно так же следует помнить, что тексты, отобранные для наших справочных корпусов (теоретическое распределение), в действительности также являются образцами, и мы не знаем, в какой мере они репрезентативны для продукции автора в целом. Нам следует предполагать, что справочный корпус является надежным показателем параметров, вовлеченных в исследование. Насколько это касается исследуемых нами текстов, мы знаем, что они не являются частью ни одного из двух справочных корпусов.
Процедура
Общий объем в 12 637 фраз, состоящих из 164 357 слов, был запущен с терминалов в аналитическую систему. Примененная в тесте транскрипция была выработана Анной-Леной Согвалл с расчетом, что ею воспользуются люди, незнакомые с кириллицией. Система включает в себя словарь художника. Каждое новое слово, добавляемое к словарю, должно быть помечено рядом критериев, так что если оно снова появится в иной флективной форме, то может быть идентифицировано автоматизированным путем. В начале настоящего исследования в этот словарь входило примерно 80% сплошного потока слов художественного текста 19 или 20 века. Осовременивание словаря оказалось непростой задачей, ответственность за решение которой легла в основном на плечи Свена Густавссона.
Как было показано ранее, система модифицирована для нашего случая; было составлено несколько
154
дополнительных программ. Эта работа была проведена в Вычислительном центре Упсалы и — недавно — Центре вычислительной лингвистики в Упсале.
Исследование по классам слов
После того как тексты были пропущены через аналитическую систему, они приняли следующий вид:
6 G С Y N Н D С
15 C N F C X N C N D
45 G G C N H N C H D Y P R C Y G C D Y G G C V D C P I Y U N D H D C D
70 N C Y N D H D Y G C Y G C Y U H D G Y G C Y C N D Y N F Y U H D C
75 N D Y G С С
Здесь каждое слово заменено обозначением его класса (см. с. 150). Последовательная нумерация относится к словам, a Y, которым обозначается несущественный пунктуационный знак, не принимается во внимание. Оригинал приведенного выше примера (из зачина ТД, 1) выглядит так:
1. Мелеховский двор — на самом краю хутора.
2. Воротца со скотиньего база ведут на север к Дону.
3. Крутой восьмисаженный спуск между замшелых в прозелени меловых глыб, и вот берег: перламутровая россыпь ракушек, серая изломистая кайма нацелованной волнами гальки и дальше — перекипающее под ветром вороненой рябью стремя Дона.
4. На восток, за красноталом гуменных плетней — гетманский шлях, полынная проседь, истоптанный конскими копытами бурый, живущо́й придорожник, часовенка на развилке; за ней — задернутая текучим маревом степь.
5. С юга — меловая хребтина горы.
155
Было проведено несколько статистических исследований данных, помеченных указателями классов. Все результаты свидетельствуют одно: распределение классов слов отличается от крюковского и напоминает шолоховское. Поэтому я приведу здесь только одно-два исследования, которые могут представлять методологический интерес.
В этих исследованиях внимание было сосредоточено на комбинациях классов слов. Ниже будут употребляться следующие термины:
BIGR | = | биграм | — | группа из 2 классов слов |
TRIG | = | триграм | — | группа из 3 классов слов |
TETRA | = | тетраграм | — | группа из 4 классов слов |
m-грам | — | группа из 2, 3 или 4 классов слов | ||
Термин «класс слов» относится к синтаксическим классам, представленным на с. 150. Работа была сосредоточена больше на обнаружении эффективных методов, нежели на статистической оценке результатов.
1. Подготовительное исследование
Дистрибутивные1 классы
Для получения данных о различительной способности комбинаций из классов слов были изучены комбинации на уровне биграм, триграм и тетраграм. Во-первых, были отобраны комбинации, обнаружившие широту относительных различий употребления между Шолоховым и Крюковым. Затем были подсчитаны ожидаемые частотности в ТД этих комбинаций,
156
предполагая, что они могут принадлежать сначала Крюкову, затем Шолохову. Наконец, ожидаемые частотности в ТД сравнивались с наблюдаемыми.
Процент употребительности любой m-грамы был взят за надежную оценку его истинной степени употребительности у рассматриваемого автора. Используя различительные m-грамы, мы преследовали цель добиться как можно большего веса доказательств в пользу одного из авторов. Чтобы достичь этого, следовало отобрать m-грамы, которые не только имеют широкую дистанцию di (т. е. разницу между авторами в относительности употребления m-грам, исчисляемых i), но также имеют высокую степень различительности ai (т. е. логарифм частного от относительных употреблений в произведениях двух писателей).
Гипотеза
Возьмем текст, содержащий n m-грам, автор которого неизвестен. Мы желаем проверить гипотезу Н0, что текст написан лицом К, против гипотезы H1, что текст написан лицом Ш. Предположим, что путем сопоставления известных произведений К и Ш было отобрано k различительных m-грам. Пусть xi — наблюдаемая частотность i-го числа m-грам в «неизвестном» тексте (ТД). Пусть вероятность i-го числа m-грам
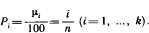 .
X1, ... Хk рассматриваются как независимые переменные, распределенные в соответствии с формулой Пуассона. Ожидаемая величина Xi, для H0: λ0i=np0i=n(μ0i/100) и для H1: λ1i=np1i=n(μ1i/100).
157
Предполагается, что параметры μ0i, и μ1i, известны из полученных процентов в текстовых корпусах К0 и Ш1. Различительная способность m-грамы частично измеряется посредством величин
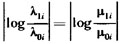 ,
а частично — посредством среднего процента  .
Тесты
BIGR
Распространеннейшей биграмой, как в корпусе Крюкова, так и Шолохова, была ND, т. е. собственно предлог, сопровождаемый флективным неодушевленным существительным. Его относительная частотность — 3,428% для корпуса К и 4.614% для корпуса Ш.
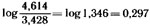 .
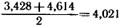 .
Тест I включал биграмы, так что
 и
 .
Эти пределы означают, что обычная биграма со средним процентом не менее учитывалась, если она употреблена по крайней мере 1,3 раза чаще у одного автора, как и у другого.
Тест II включал биграмы, так что
 и
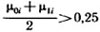 .
158
И тест III в заключение также включал биграмы, так что
 и
 .
В этом тесте включались более редкие биграмы при условии, что они использовались вдвое чаще у одного автора в сравнении с другим.
Различительные биграмы в тестах I, II и III:
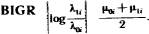 .
Тест I
DX | 0,661 | 1,287 |
ЕХ | —0,526 | 1,198 |
NC | 0,477 | 2,119 |
ND | 0,297 | 4,021 |
NF | —0,428 | 1,269 |
РХ | —0,637 | 1,045 |
YX | 0,292 | 2,292 |
Тест II | ||
CC | 0,350 | 0,419 |
DP | —0,409 | 0,767 |
FH | —0,882 | 0,287 |
GY | —0,746 | 0,781 |
НВ | —0,482 | 0,341 |
HY | —0,653 | 0,599 |
IP | —0,785 | 0,300 |
IY | —0,708 | 0,520 |
PI | —0,557 | 0,549 |
RI | —0,592 | 0,302 |
TN | 0,560 | 0,396 |
TY | 0,859 | 0,313 |
UC | 0,361 | 0,325 |
159
VN | 0,381 | 0,274 |
XA | 0,699 | 0,538 |
XP | —0,386 | 0,545 |
XR | —0,444 | 0,758 |
XS | —0,474 | 0,553 |
YA | 0,382 | 0,313 |
YE | —0,332 | 0,454 |
YG | —0,816 | 0,926 |
YH | —0,848 | 0,537 |
YJ | —0,378 | 0,428 |
YT | 0,671 | 0,909 |
YY | —1,546 | 0,402 |
Тест III | ||
CG | 0,689 | 0,166 |
DG | 0,985 | 0,177 |
IT | 0,788 | 0,168 |
RG | —0,869 | 0,176 |
RT | 0,703 | 0,225 |
SY | —0,706 | 0,232 |
TC | 0,969 | 0,160 |
TD | 0,982 | 0,185 |
При помощи различительных биграм были подсчитаны в процентах их ожидаемые частотности в пассажах из ТД. Биграма ND, например, имела употребляемость 3,428% в корпусе К и 4,614% в корпусе Ш. Это давало ожидаемую частотность в ТД, 1, которая состояла из 13 393 биграм, 459,11 для гипотезы в пользу Крюкова и 617,95 для гипотезы в пользу Шолохова. Наблюдаемая частотность в ТД, 1 была 664.
Подсчеты производились на трех подкорпусах ТД: ТД, 1 (n=13 393); ТД, 2 (n=16 439); ТД, 4 (n=21 952) и на всем корпусе ТД (n=51 784). Табл. 3.1—3.3, приводимые ниже, показывают наблюдаемые
160
частотности различительных биграм во всех текстах ТД. Гипотезами были: H0 — автор текста Крюков и H1 — автор текста Шолохов.
Таблица 3.1
Частотность. Всего по ТД
[Группа] BIGR | Предполагаемая | Наблюдаемая X1 | |
H0 | H1 | ||
DX | 463,63 | 878,77 | 780 |
EX | 779,87 | 460,88 | 326 |
NC | 840,45 | 1353,63 | 1255 |
ND | 1775,16 | 2389,31 | 2355 |
NF | 795,40 | 518,36 | 494 |
PX | 707,89 | 374,40 | 293 |
YX | 1014,45 | 1358,45 | 1668 |
CC | 179,17 | 254,26 | 294 |
DP | 476,93 | 316,92 | 299 |
FH | 210,24 | 87,00 | 105 |
GY | 548,39 | 259,96 | 316 |
HB | 218,01 | 134,64 | 195 |
HY | 408,06 | 212,31 | 240 |
IP | 213,35 | 97,35 | 68 |
IY | 360,42 | 177,62 | 137 |
PI | 361,45 | 207,14 | 116 |
RI | 200,40 | 110,82 | 64 |
TN | 149,14 | 260,99 | 397 |
TY | 96,32 | 227,33 | 325 |
UC | 138,26 | 198,33 | 224 |
VN | 114,96 | 168,30 | 231 |
XA | 184,87 | 371,81 | 306 |
XP | 336,08 | 228,37 | 144 |
XR | 477,97 | 306,56 | 239 |
XS | 352,65 | 219,56 | 177 |
YA | 131,53 | 192,64 | 252 |
YE | 273,42 | 196,26 | 174 |
YG | 664,91 | 294,13 | 386 |
YH | 389,42 | 166,74 | 185 |
YJ | 263,06 | 180,21 | 144 |
YT | 318,47 | 622,96 | 1006 |
YY | 342,81 | 73,02 | 125 |
CG | 57,48 | 114,44 | 90 |
DG | 49,71 | 133,08 | 181 |
161
Продолжение табл. 3.1
[Группа] BIGR | Предполагаемая | Наблюдаемая X1 | |
H0 | H1 | ||
IT | 54,37 | 119,62 | 116 |
RG | 128,42 | 53,86 | 40 |
RT | 77,16 | 155,87 | 114 |
SY | 160,53 | 79,23 | 73 |
ТС | 45,57 | 120,14 | 166 |
TD | 53,34 | 137,75 | 189 |
Из таблицы видно, что за исключением НВ наблюдаемая частотность (Xi) всех BIGR гораздо ближе к H1, чем к H0.
TRIG
Тестирование триграм включало триграмы, так что
 и
 .
Таблица 3.2
Частотность. Всего по ТД (n=48 058)
[Группа] TRIG | Предполагаемая | Наблюдаемая X1 | |
H0 | H1 | ||
CYX | 210,97 | 330,16 | 406 |
DXN | 108,61 | 172,53 | 186 |
DYX | 231,16 | 387,35 | 553 |
GYG | 241,73 | 64,40 | 86 |
IPI | 167,24 | 77,37 | 56 |
NCY | 228,28 | 370,53 | 308 |
NDC | 77,85 | 180,22 | 196 |
NDP | 171,09 | 90,35 | 91 |
NDX | 142,73 | 341,21 | 279 |
NFD | 184,54 | 114,38 | 106 |
162
Продолжение табл. 3.2
[Группа] TRIG | Предполагаемая | Наблюдаемая X1 | |
H0 | H1 | ||
PXN | 171,09 | 106,21 | 98 |
XCY | 138,89 | 225,87 | 228 |
XNC | 248,46 | 457,51 | 414 |
XNF | 263,97 | 143,21 | 148 |
ХРХ | 211,94 | 102,84 | 85 |
YGC | 163,40 | 99,00 | 98 |
YGY | 188,39 | 60,07 | 81 |
YIX | 98,04 | 174,45 | 132 |
YNH | 246,54 | 120,15 | 180 |
YTN | 90,35 | 161,47 | 278 |
YXN | 198,96 | 397,44 | 500 |
Из таблицы видно, что за исключением YIX наблюдаемая частотность (X1) всех TRIG гораздо ближе к H1, чем к H0.
TETRA
Тестирование тетраграм включало тетраграмы, так что
 и
 .
Таблица 3.3
Частотность. Всего по ТД (n=44 408)
[Группа] TETRA | Предполагаемая | Наблюдаемая X1 | |
H0 | H1 | ||
CYXN | 38,63 | 99,03 | 104 |
DYNH | 83,04 | 45,74 | 50 |
DYXN | 50,18 | 127,45 | 195 |
GYGC | 81,27 | 19,54 | 23 |
GYGY | 91,92 | 19,54 | 24 |
163
Продолжение табл. 3.3
[Группа] TETRA | Предполагаемая | Наблюдаемая X1 | |
H0 | H1 | ||
HDYN | 71,50 | 48,40 | 50 |
HYHD | 95,92 | 23,09 | 25 |
NCYX | 45,30 | 92,37 | 76 |
NDYX | 83,04 | 124,34 | 149 |
NFDY | 63,94 | 35,52 | 38 |
NHDX | 51,07 | 72,83 | 67 |
RXND | 39,52 | 58,62 | 29 |
XNCY | 59,95 | 133,22 | 111 |
XNDY | 115,90 | 166,53 | 166 |
YGYG | 82,15 | 18,65 | 26 |
YNHD | 96,81 | 64,39 | 96 |
YXNC | 41,74 | 129,23 | 118 |
YXND | 64,84 | 130,12 | 196 |
YXYX | 69,72 | 35,97 | 42 |
Из таблицы видно, что за исключением RXND и YNHD наблюдаемые частотности (Xi) всех TETRA гораздо ближе к H1, чем к H0.
2. Сплошной тест
Большинство методов определения авторства отличается следующими особенностями. Подбираются справочные корпусы, состоящие из атрибутированных произведений писателей, претендующих на авторство обсуждаемого текста. Затем подсчитываются повторяемости какого-либо явления, которое, как считается, способно служить различителем. Лишь затем подсчитывается повторяемость явления в сомнительной работе и отмечается, к которому из потенциальных авторов наблюдаемые частотности ближе всего подходят. Этим принципиальным шагам в целом необходимо следовать. Если начать исследование с другого конца, с сомнительного текста, легко впасть в ошибку при
164
решении вопроса о выборе объективных критериев. Слабость большинства методов состоит в том, что сомнительный текст должен обладать достаточной длиной, чтобы поддаться статистическому сопоставлению. При помощи существующих методов нелегко обнаружить инородную пару страниц внутри текста, даже при наличии, в целях сопоставления, большого справочного корпуса. Необходим метод, сводящий к минимуму количество сомнительного материала, требуемого для теста, чтобы этот тест был убедителен. В идеале хотелось бы получить возможность судить о вероятном авторстве на основе небольшого числа — скажем, 20—30 фраз. Это заставило меня целенаправленно искать метод, при помощи которого от фразы к фразе все синтаксические комбинации можно было бы изучать и сравнивать с вероятностями, подсчитанными на основе справочного корпуса. Путем умножения вероятностей мы получили бы измерение для каждой фразы, показывающее в нашем случае, насколько эта фраза приложима к тексту Крюкова или Шолохова. Такой метод и был разработан для настоящего исследования. Поскольку каждое слово фразы своей синтаксической принадлежностью вносит вклад в результаты теста, я называю его «сплошным тестом».
Этот метод, вероятно, более эффективен при исследовании русскоязычных текстов, со свободным порядком слов, но вполне возможно, что применим и к другим языкам.
Позиционно-обусловленные биграмы
Ранее было показано, что позиции начала и конца фразы обнаруживают иное распределение по классам слов, чем язык в целом; более того, различные авторы по-своему начинают и заканчивают фразу.
165
Таблица 3.4
[Частотность (в %)]
[Тексты] | [Число | Позиции | |||||||
B1—2 | B2—3 | B3—4 | B4—5... | E5—4 | E4—3 | E3—2 | E2—1 | ||
К | 10 | 33,19 | 28,81 | 23,35 | 24,76 | 23,43 | 22,95 | 26,07 | 41,39 |
К | 20 | 46,35 | 44,03 | 37,74 | 39,02 | 38,10 | 36,87 | 38,83 | 53,78 |
Ш | 10 | 38,22 | 30,53 | 28,15 | 29,30 | 29,47 | 28,65 | 29,93 | 44,68 |
Ш | 20 | 52,09 | 45,05 | 42,33 | 42,02 | 43,34 | 41,21 | 42,43 | 60,42 |
ТД | 10 | 46,70 | 34,11 | 29,17 | 29,33 | 31,65 | 30,28 | 30,59 | 45,43 |
ТД | 20 | 58,77 | 49,97 | 43,28 | 41,97 | 44,45 | 43,20 | 45,77 | 61,86 |
За позицией B4 (4-я позиция от начала) во фразе исчезает влияние начала фразы, так что в позиции E5 (5-я позиция от конца) начинается влияние позиции конца фразы. В какой-то мере это можно увидеть при изучении биграм в позициях B1—2, B2—3, B3—4, B4—5 и E5—4, E4—3, E3—2, E2—1, отмечая процент повторяемости, на который указывают биграмы, наиболее обычные для каждой позиции. 10 и 20 самых обычных биграм, будучи распределенными по позиции и автору, обусловили следующие проценты повторяемости.
Данные табл. 3.4 могут служить показателями того, насколько каждый из авторов склонен к использованию особых комбинаций классов слов. Стилистические особенности, нашедшие отражение в таблице, можно, вероятно, выразить следующим образом: Крюков обнаруживает относительно классов слов куда больше вариаций в начале и конце фразы, чем Шолохов (и автор ТД). В позиции начала фразы ТД особенно стереотипен. Из других исследований, приводимых в этой работе, мы знаем, что Шолохов (вместе с автором ТД) обнаруживает большую лексическую вариативность, чем Крюков. В сравнении с
166
Крюковым Шолохов использует меньше синтаксических формул, но заполняет их большим количеством различных слов.
В программе теста относительные частотности биграм для позиций от B1—2 до B3—4 и от E5—4 до E2—1, взятые из корпусов Ш и К, использовались для выражения вероятностей в позициях начала и конца фразы. Для всех позиций, ближе к центру фразы, использовались частотности для позиции B4—5.
Для фраз, состоящих из 8 биграм (9 слов) или меньше, была проведена специальная граница, отделяющая влияние начала и конца фразы следующим образом:
Фразы из двух биграм имеют начальное влияние на 1 биграм
Фразы из 3 биграм имеют начальное влияние на 1 биграм
Фразы из 4 биграм имеют начальное влияние на 1 биграм
Фразы из 5 биграм имеют начальное влияние на 2 биграм
Фразы из 6 биграм имеют начальное влияние на 2 биграм
Фразы из 7 биграм имеют начальное влияние на 3 биграм
Фразы из 8 биграм имеют начальное влияние на 4 биграм.
Выбор теста
Мы, конечно, стремимся к наилучшему по качеству тесту. Чем характеризуется здесь «хороший» тест? Для определения качества теста можно ввести следующие величины: α — вероятность приписывания К фразы, написанной Ш; β — вероятность приписывания Ш фразы, написанной К.
167
Тест, сводящий к минимуму α+β, представляется в известном смысле хорошим. Тест этот весьма прост. Предположим, что возможно определить вероятность пассажа, которая появилась бы, будь автором Ш (Ps), и соответствующую вероятность, если автор — К (Pk). Тогда ясно, чтобы получить максимально меньшее увеличение α+β, текст должен принадлежать Ш при Ps>Pk в противном случае — К.
Остается лишь найти эффективный метод для определения вероятности того, что конкретный текст создан неким автором. Предположим, что в отношении класса слов текст представляет собой цепь Маркова, т. е. принадлежность к классу слов обладает распределением вероятности, зависящей только от класса предыдущего слова. Мы можем говорить о вероятностях перехода p(i, j), т. е. вероятности, что за словом в классе слов i — будет следовать слово в классе слов j. Эти вероятности перехода обусловлены позиционно. Позиционная зависимость особенно велика в начале и конце фразы. Мы вводим также вероятность pi, для фразы, начинающейся классом слов i.
Все эти вероятности определяются статистикой, полученной из известных текстов. Таким образом, самостоятельные наборы вероятностей мы получим для разных авторов.
Следовательно, переменные для нашего теста таковы (предполагая, что фраза будет x1, x2, x3...xn):
Тест I
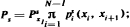
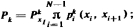
Индексы s и k означают двух авторов, Шолохова и Крюкова. Этот тест (тест I) сработал успешно.
168
Его различительная способность была проверена на подлинных текстах Ш и К, состоящих из отобранных наугад отрывков по 10 фраз от справочного корпуса.
Подлинные тексты Ш:
На 23 пассажа из 10 фраз тест показал наличие фраз Ш в 12 случаях, преимущественно фраз К в 5 случаях и столько же на каждого в 6 случаях.
Подлинные тексты К:
На 23 пассажа тест показал наличие в основном фраз К в 22 случаях, в основном фраз Ш в 0 случаев и равное количество в 1 случае.
В целом 57,0% фраз в текстах Ш были приписаны Ш и 43,0% — К.
В целом 77,4% фраз в текстах К были приписаны К и 22,6% — Ш.
Тест I обнаружил явно выраженную тенденцию в пользу К.
Одной из проблем при выборе такого теста был вопрос о том, насколько соответствует истине посылка, будто мы имеем дело с цепями Маркова. При всех условиях тест несовершенен. Поэтому применим следующий альтернативный тест.
Пусть qks(i, j) вероятность того, что биграм в позиции k—k+1 будет состоять из одного слова в классе i и одного слова в классе слов j (в произведениях автора Ш).
Тест II
Пусть 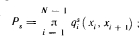
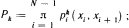
Этот тест (тест II) давал более высокие величины там, где автор использовал классы слов, привычных для его творчества. Несколько неожиданно то, что тест II дал лучшие, чем тест I, результаты применительно к тем же текстам Ш и К.
Результаты.
Тексты Ш.
На 23 пассажа тест показал преобладание фраз Ш
169
в 22 случаях, в основном фраз К в 1 случае и равное количество в 0 случаев.
Тексты К.
На 23 пассажа тест показал преобладание фраз К в 17 случаях, фраз Ш в 3 случаях и равное количество в 3 случаях.
В целом 76,9% фраз в текстах Ш приписывалось Ш и 23,1% — К.
В целом 68,6% фраз в текстах К приписывалось К и 31,4% — Ш.
Тест II имеет тенденцию в пользу Ш.
Ни один из тестов не дает ни Ш, ни К одинаково равных исходных шансов. При выборе теста следует предпочесть тот, который сводит к минимуму α+β.
Процент ошибки в тесте I был 43,0 для Ш и 22,6 для К. Всего — 65,6.
Процент ошибки в тесте II был 23,1 для Ш и 31,4 для К. Всего — 54,5.
Тест II является лучшим из двух. Он дает убедительные результаты в случаях и Ш, и К.
Результаты для подкорпуса Ш, III который отличается во многих отношениях от Ш, I и Ш, II, были примерно так же ясны в этом тесте, как и для Ш, I и Ш, II. Из 79 проверяемых фраз 58 приписывались Ш и 21 — К, т. е. 73,4% и 26,6% соответственно.
Из соображений полноты, приведем ниже результаты обоих тестов.
Результаты теста по «Тихому Дону».
Наугад взятые примеры для каждого из подкорпусов ТД, 1, ТД, 2 и ТД, 4 были получены путем тестирования первых десяти фраз каждой второй страницы компьютерной распечатки. Результаты приводятся в нижеследующих табл. 3.5—3.7.
170
Таблица 3.5
ТД, 1
№ | Кол-во | Порядок слов | Кол-во | Тест I. | Тест II. | Тест I. | Тест II | ||
Ш | К | Ш | К | Преимущественно | |||||
1 | 10 | 1—122 | 123 | 6 | 4 | 8 | 2 | Ш | Ш |
2 | 10 | 801—914 | 114 | 7 | 3 | 10 | 0 | Ш | Ш |
3 | 10 | 1 384—1 510 | 127 | 2 | 8 | 7 | 3 | К | Ш |
4 | 10 | 2 001—2 079 | 79 | 9 | 1 | 9 | 1 | Ш | Ш |
5 | 10 | 2 573—2 661 | 89 | 6 | 4 | 8 | 2 | Ш | Ш |
6 | 10 | 3 148—3 212 | 65 | 5 | 5 | 7 | 3 | X | Ш |
7 | 10 | 3 671—3 855 | 185 | 9 | 1 | 9 | 1 | Ш | Ш |
8 | 10 | 4 398—4 498 | 101 | 5 | 5 | 7 | 3 | X | Ш |
9 | 10 | 5 012—5 092 | 81 | 5 | 5 | 8 | 2 | X | Ш |
10 | 10 | 5 630—5 744 | 145 | 7 | 3 | 8 | 2 | Ш | Ш |
11 | 10 | 6 415—6 565 | 151 | 6 | 4 | 5 | 5 | Ш | X |
12 | 10 | 6 916—6 987 | 72 | 7 | 3 | 9 | 1 | Ш | Ш |
13 | 10 | 7 363—7 479 | 117 | 7 | 3 | 8 | 2 | Ш | Ш |
14 | 10 | 7 991—8 075 | 85 | 4 | 6 | 7 | 3 | К | Ш |
15 | 10 | 8 654—8 777 | 124 | 8 | 2 | 9 | 1 | Ш | Ш |
16 | 10 | 9 231—9 305 | 74 | 4 | 6 | 8 | 2 | К | Ш |
17 | 10 | 9 911—10 115 | 204 | б | 4 | 6 | 4 | Ш | Ш |
18 | 10 | 10 915—11 063 | 149 | 7 | 3 | 7 | 3 | Ш | Ш |
19 | 10 | 11 573—11 695 | 123 | 6 | 4 | 10 | 0 | Ш | Ш |
20 | 10 | 12 320—12 384 | 65 | 5 | 5 | 8 | 2 | X | Ш |
171
Таблица 3.6
ТД, 2
№ | Кол-во фраз | Порядок слов | Кол-во слов | Тест I. Фразы типа | Тест II. Фразы типа | Тест I. | Тест II | ||
Ш | К | Ш | К | Преимущественно | |||||
1 | 10 | 1—209 | 209 | 6 | 4 | 7 | 3 | Ш | Ш |
2 | 10 | 882—1 047 | 166 | 6 | 4 | 7 | 3 | Ш | Ш |
3 | 10 | 1 665—1 760 | 96 | 6 | 4 | 8 | 2 | Ш | Ш |
4 | 10 | 2 325—2 454 | 113 | 8 | 2 | 9 | 1 | Ш | Ш |
5 | 10 | 3 273—3 394 | 122 | 6 | 4 | 9 | 1 | Ш | Ш |
6 | 10 | 4 006—4 128 | 123 | 3 | 7 | 8 | 2 | К | Ш |
7 | 10 | 4 853—5 058 | 206 | 7 | 3 | 9 | 1 | Ш | Ш |
8 | 10 | 5 562—5 707 | 146 | 4 | 6 | 7 | 3 | К | Ш |
9 | 10 | 6 403—6 286 | 118 | 6 | 4 | 8 | 2 | Ш | Ш |
10 | 10 | 6 979—7 093 | 115 | 5 | 5 | 8 | 2 | X | Ш |
11 | 10 | 7 636—7 770 | 135 | 4 | 6 | 9 | 1 | К | Ш |
12 | 10 | 8 501—8 683 | 183 | 5 | 5 | 8 | 2 | X | Ш |
13 | 10 | 9 277—9 378 | 102 | 3 | 7 | 7 | 3 | К | Ш |
14 | 10 | 9 982—10 106 | 125 | 6 | 4 | 10 | 0 | Ш | Ш |
15 | 10 | 10 715—10 820 | 105 | 6 | 4 | 10 | 0 | Ш | Ш |
16 | 10 | 11 607—11 760 | 154 | 8 | 2 | 8 | 2 | Ш | Ш |
17 | 10 | 12 292—12 433 | 142 | 6 | 4 | 9 | 1 | Ш | Ш |
18 | 10 | 13 162—13 320 | 159 | 5 | 5 | 5 | 5 | X | X |
19 | 10 | 13 931—14 025 | 95 | 9 | 1 | 8 | 2 | Ш | Ш |
20 | 10 | 14 642—14 822 | 181 | 6 | 4 | 8 | 2 | Ш | Ш |
172
Таблица 3.7
ТД, 4
№ | Кол-во фраз | Порядок слов | Кол-во слов | Тест I. Фразы типа | Тест II. Фразы типа | Тест I. | Тест II | ||
Ш | К | Ш | К | Преимущественно | |||||
1 | 10 | 1—4; 7—9; 11—105 | 102 | 7 | 3 | 9 | 1 | Ш | Ш |
2 | 10 | 674—763 | 90 | 5 | 5 | 9 | 1 | X | Ш |
3 | 10 | 1 465—1 607 | 143 | 6 | 4 | 9 | 1 | Ш | Ш |
4 | 10 | 2 454—2 571 | 118 | 4 | 6 | 8 | 2 | К | Ш |
5 | 10 | 3 275—3 470 | 196 | 8 | .2 | 9 | 1 | Ш | Ш |
6 | 10 | 4 126—4 402 | 277 | 6 | 4 | 9 | 1 | Ш | Ш |
7 | 10 | 5 109—5 226 | 118 | 8 | 2 | 9 | 1 | Ш | Ш |
8 | 10 | 5 939—6 076 | 138 | 7 | 3 | 7 | 3 | Ш | Ш |
9 | 10 | 7 012—7 159 | 148 | 8 | 2 | 10 | 0 | Ш | Ш |
10 | 10 | 8 042—8 203 | 162 | 6 | 4 | 8 | 2 | Ш | Ш |
11 | 10 | 9 012—9 133 | 122 | 6 | 4 | 7 | 3 | Ш | Ш |
12 | 10 | 9 858—9 947 | 90 | 3 | 7 | 5 | 5 | К | X |
13 | 10 | 10 747—10 937 | 191 | 8 | 2 | 8 | 2 | Ш | Ш |
11 730—11 903 | 174 | ||||||||
14 | 10 | 11 958—11 967 | 10 | 7 | 3 | 8 | 2 | Ш | Ш |
15 | 10 | 12 656—12 675 | 20 | 7 | 3 | 8 | 2 | Ш | Ш |
12 677—12 868 | 192 | ||||||||
16 | 10 | 13 574—13 701 | 134 | 5 | 5 | 8 | 2 | X | Ш |
17 | 10 | 14 449—14 541 | 93 | 4 | 6 | 6 | 4 | К | Ш |
18 | 10 | 15 172—15 257 | 86 | 5 | 5 | 7 | 3 | X | Ш |
19 | 10 | 15 864—16 082 | 219 | 3 | 7 | 6 | 4 | К | Ш |
20 | 10 | 16 833—16 997 | 145 | 3 | 7 | 5 | 5 | К | X |
21 | 10 | 17 515—17 622 | 108 | 6 | 4 | 9 | 1 | Ш | Ш |
22 | 10 | 18 124—18 222 | 99 | 7 | 3 | 8 | 2 | Ш | Ш |
23 | 10 | 18 746—18 872 | 127 | 6 | 4 | 8 | 2 | Ш | Ш |
24 | 10 | 19 536—19 683 | 148 | 3 | 7 | 6 | 4 | К | Ш |
173
Суммарные результаты
Таблица 3.8
Пассажи | Тест I | Тест II | ||||
Ш | К | X | Ш | К | X | |
ТД, 1 | 13 | 3 | 4 | 19 | 0 | 1 |
ТД, 2 | 13 | 4 | 3 | 19 | 0 | 1 |
ТД, 4 | 15 | 6 | 3 | 22 | 0 | 2 |
Всего в ТД | 41 | 13 | 10 | 60 | 0 | 4 |
Вышеприведенные результаты можно сравнить с данными для подлинных текстов Ш и К.
Таблица 3.9
[Подлинный | Тест I | Тест II | ||||
Ш | К | X | Ш | К | X | |
Ш | 12 | 5 | 6 | 22 | 1 | 0 |
К | 0 | 22 | 1 | 3 | 17 | 3 |
Результаты теста ТД поразительно наглядны. Поскольку подлинные тексты являются подразделами справочного корпуса, использованного в тестах, можно было ожидать несколько более равных значений для «незнакомых» текстов. Однако данные ТД, полученные при столь же широком поле тестирования, что и подлинные тексты Ш и К, указывают на Шолохова.
Мы можем также сопоставить количество фраз, бесспорно принадлежащих Шолохову, с ожидаемым количеством, высчитанным на основе процента фраз Ш в подлинных текстах Ш и К. Гипотеза1: H0 — автор Шолохов; H1 — автор Крюков.
174
Таблица 3.10
[Тексты] | Предложения | Тест I | Тест II | ||||
Явный | Ожидаемые: | Явный | Ожидаемые: | ||||
H0 | H1 | H0 | H1 | ||||
ТД, 1 | 200 | 121 | 114,0 | 45,2 | 158 | 153,8 | 62,8 |
ТД, 2 | 200 | 115 | 114,0 | 45,2 | 162 | 153,8 | 62,8 |
ТД, 4 | 240 | 138 | 136,8 | 54,2 | 186 | 184,6 | 75,4 |
ТД, 1, 2, 4 | 640 | 374 | 364,8 | 144,6 | 506 | 492,2 | 201,0 |
Заключительные замечания
Высокая различительная способность теста может быть объяснена несколькими причинами:
25 классов дают хороший уровень абстрагирования для слов;
комбинации из двух классов слов дают уровень, на котором индивидуальные особенности ясно выделяются;
построение фраз, насколько оно отражено в тексте, составляет глубоко присущую автору особенность и не меняется ни под влиянием сюжета, ни в процессе творческого развития автора.
Сноски к стр. 145
1 Beckman B. Försök med en metod för mätning av skillnader i författarstil. Stokholms universitet; Slaviska institutionen, 1966. Неопубликованная работа.
2 Kjetsaa G. Storms on the Quiet Don. A pilot Study // Scando-Slavica. 1976. Vol. 22. P. 5—24.
Сноски к стр. 147
1 См.: Sågvall A.-L. A System for Automatic Inflectional Analysis. Implemented for Russian. Stockholm: Almqvist & Wiksell 1973. (Data Linguistica. 8).
Сноски к стр. 150
1 Sågvall A.-L. Op. cit. P. 21—23.
Сноски к стр. 155
1 О методе, примененном здесь, см.: Särndal C.-E. On Deciding Cases of Disputed Authorship // Applied Statistics. 1967. Vol. 16. N 3. P. 251—268.
Сноски к стр. 173
1 Уточняем для читателя: в гипотезе, рассмотренной в табл. 3.1—3.3, обозначение было иное: H0 — автор Крюков; H1 — автор Шолохов. (Примеч. ред.)